メインコンテンツまでスキップ

「AWS」タグの記事が97件件あります

全てのタグを見る

· 約1分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

ESP32をAWS IoTにつなぐ方法です。 自分用のメモです。

Arduino+外部ライブラリー(MQTT+ArduinoJson)​

簡単度:★★★★★

一般的なArduinoのライブラリー(MQTTとArduinoJson)を使って実現します。

参考 https://github.com/aws-samples/aws-iot-esp32-arduino-examples https://aws.amazon.com/jp/blogs/compute/building-an-aws-iot-core-device-using-aws-serverless-and-an-esp32/

Arduino+AWS製ライブラリー​

期待度:★★★★★

aws-samplesのリポジトリ内で開発されています。Amazon iot C-SDKに存在しないGreengrass部分を開発しているようです。 名前がGreengrassとなっていますが、AWS IoTと直接やり取りすることもできます。

参考 https://github.com/aws-samples/arduino-aws-greengrass-iot

FreeRTOS​

本気度:★★★★★

お手軽ではありませんが、AWS謹製でございます。おそらく新機能も一番早いでしょう

https://aws.amazon.com/jp/freertos/

· 約8分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

AWS Lambdaで動作するJavaは初回が遅いですが、速くする方法がないか調べました。 末尾にある参考サイトの内容にたどり着いて、実際に試してみたのでその記録です。

レイテンシ情報はX-Rayにて取得しました。

テスト対象​

S3にファイルをPUTするだけのものです

S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("filename.txt").build(),
RequestBody.fromString("contents"));

検証1 普通に実行​

まずは普通に試してみます。

ソース全体
package helloworld;

import com.amazonaws.services.lambda.runtime.Context;
import com.amazonaws.services.lambda.runtime.RequestHandler;

import software.amazon.awssdk.core.sync.RequestBody;
import software.amazon.awssdk.regions.Region;
import software.amazon.awssdk.services.s3.S3Client;
import software.amazon.awssdk.services.s3.model.PutObjectRequest;
import software.amazon.awssdk.services.s3.model.PutObjectResponse;

public class TestTarget0429 implements RequestHandler<Object, Object> {

public Object handleRequest(final Object input, final Context context) {
String ENV_BUCKET = System.getenv("BUCKET");

S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("filename.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);

return null;
}
}
回数レイテンシ(ms)処理内容
16200
2422
3217
4210
5315

1回目だけ遅い、いわゆるコールドスタートが遅い状態ですね。 S3に1ファイル作成するだけで6秒は遅いですよねぇ。

検証2 Provisioned Concurrencyを有効化​

では昨年末に登場したProvisioned Concurrencyを使うとどうでしょう。 https://aws.amazon.com/jp/blogs/news/new-provisioned-concurrency-for-lambda-functions/

ソースコードは検証1と同じものです。

回数レイテンシ(ms)処理内容
15500
2266
3274
4402
5304

初回が遅いままじゃないか。。 同時実行1をプロビジョンドしただけでも月$14.42かかるのに、あんまりじゃないか。。。

なので、以降はProvisioned Concurrencyを無効にして検証を続けます

検証3 処理の分離(Provisioned Concurrencyなし)​

初回に遅い原因を探るため、Lambda初回起動時と2回目起動時で処理を分けてみました。

staticなcount変数を作って、初回呼び出し時のみ速攻returnしてみます。

        if (count == 1) {
count++;
return null;
}
ソース全体
package helloworld;

import com.amazonaws.services.lambda.runtime.Context;
import com.amazonaws.services.lambda.runtime.RequestHandler;

import software.amazon.awssdk.core.sync.RequestBody;
import software.amazon.awssdk.regions.Region;
import software.amazon.awssdk.services.s3.S3Client;
import software.amazon.awssdk.services.s3.model.PutObjectRequest;
import software.amazon.awssdk.services.s3.model.PutObjectResponse;

public class TestTarget0429 implements RequestHandler<Object, Object> {

private static int count = 1;

public Object handleRequest(final Object input, final Context context) {
if (count == 1) {
count++;
return null;
}

String ENV_BUCKET = System.getenv("BUCKET");

S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("filename.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);

return null;
}
}

結果​

回数レイテンシ処理内容
1625msInitialization処理のみ
25600msS3 PUT(1回目)
3393msS3 PUT(2回目)
4401msS3 PUT(3回目)
5311msS3 PUT(4回目)

Initialization処理が遅いわけじゃないことがわかりました。 S3 PUT(初回)に時間がかかっているようです。

検証4 初期化処理をstaticにする(Provisioned Concurrencyなし)​

S3Clientを作る部分をstatic化してみます。

private static String ENV_BUCKET = System.getenv("BUCKET");
private static S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();
ソース全体
package helloworld;

import com.amazonaws.services.lambda.runtime.Context;
import com.amazonaws.services.lambda.runtime.RequestHandler;

import software.amazon.awssdk.core.sync.RequestBody;
import software.amazon.awssdk.regions.Region;
import software.amazon.awssdk.services.s3.S3Client;
import software.amazon.awssdk.services.s3.model.PutObjectRequest;
import software.amazon.awssdk.services.s3.model.PutObjectResponse;

public class TestTarget0429 implements RequestHandler<Object, Object> {

private static int count = 1;

private static String ENV_BUCKET = System.getenv("BUCKET");
private static S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();

public Object handleRequest(final Object input, final Context context) {
if (count == 1) {
count++;
return null;
}

PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("filename.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);

return null;
}
}

結果​

回数レイテンシ処理内容
12400msInitialization処理 と S3Clientインスタンスの生成
22200msS3 PUT(1回目)
343msS3 PUT(2回目)
446msS3 PUT(3回目)
578msS3 PUT(4回目)

お!少し1回目の処理時間がかかるようになって、2回目が少し早くなりましたね。 3回目以降も早くなってますがこれもなにか影響があるのでしょうか?

検証5 staticイニシャライザで1回やっちゃう(Provisioned Concurrencyなし)​

staticで処理をすれば早くなることがわかりました。 一旦staticイニシャライザでダミーファイルを作成してみます。

static{
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("dummy.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);
}
ソース全体
package helloworld;

import com.amazonaws.services.lambda.runtime.Context;
import com.amazonaws.services.lambda.runtime.RequestHandler;

import software.amazon.awssdk.core.sync.RequestBody;
import software.amazon.awssdk.regions.Region;
import software.amazon.awssdk.services.s3.S3Client;
import software.amazon.awssdk.services.s3.model.PutObjectRequest;
import software.amazon.awssdk.services.s3.model.PutObjectResponse;

public class TestTarget0429 implements RequestHandler<Object, Object> {

private static int count = 1;

private static String ENV_BUCKET = System.getenv("BUCKET");
private static S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();

static{
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("dummy.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);
}

public Object handleRequest(final Object input, final Context context) {
if (count == 1) {
count++;
return null;
}

PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("filename.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);

return null;
}
}

結果​

回数レイテンシ処理内容
14000msInitialization処理 と staticメソッドによるS3 PUT(1回目)ダミーファイル
242msS3 PUT(2回目)
3125msS3 PUT(3回目)
442msS3 PUT(4回目)
544msS3 PUT(5回目)

めでたく2回目以降が速くなりましたよ~!

検証6 検証5+Provisioned Concurrency​

検証5で早くなったので、Provisioned Concurrencyも組み合わせたら、1回目から速くなるのか?!

ソースは検証5と同じものです。

回数レイテンシ処理内容
180msInitialization処理
2370msS3 PUT(2回目)※Provisionedの際にstaticイニシャライザで1回実行済みのため
343msS3 PUT(3回目)
472msS3 PUT(4回目)
584msS3 PUT(5回目)

やりましたよ! 期待してたのはこれです。

最終結果​

最終形はこうなりました。

  • staticメソッドでダミーファイル作成を一回やっちゃう
  • Provisioned Concurrency有効
ソース全体
package helloworld;

import com.amazonaws.services.lambda.runtime.Context;
import com.amazonaws.services.lambda.runtime.RequestHandler;

import software.amazon.awssdk.core.sync.RequestBody;
import software.amazon.awssdk.regions.Region;
import software.amazon.awssdk.services.s3.S3Client;
import software.amazon.awssdk.services.s3.model.PutObjectRequest;
import software.amazon.awssdk.services.s3.model.PutObjectResponse;

public class TestTarget0429 implements RequestHandler<Object, Object> {

private static String ENV_BUCKET = System.getenv("BUCKET");
private static S3Client s3 = S3Client.builder().region(Region.AP_NORTHEAST_1).build();

static{
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("dummy.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);
}

public Object handleRequest(final Object input, final Context context) {
PutObjectResponse result = s3.putObject(
PutObjectRequest.builder().bucket(ENV_BUCKET).key("filename.txt").build(),
RequestBody.fromString("contents"));

System.out.println(result);

return null;
}
}
回数レイテンシ処理内容
1552msS3 PUT(2回目)※Provisionedの際にstaticイニシャライザで1回実行済みのため
2118msS3 PUT(3回目)
344msS3 PUT(4回目)
486msS3 PUT(5回目)
5146msS3 PUT(6回目)

めでたし、めでたし。

考察​

どうも、Javaのクラスローダーは初めてクラスが呼ばれたタイミングでクラスを読み込むようで、クラスの初期ロードに時間がかかるらしいです。 なので、一回読み込んじゃって、クラスをロード済みにしてしまえば次から速いということのようです。

呼ばれたタイミングじゃなくて、はじめに全部クラスをロードしてくれたらいいんですが、そんなことはできないのですかねぇ。

参考サイトはこちらです。

クラスメソッドさんのブログ https://dev.classmethod.jp/articles/report-best-practive-for-java-on-lambda/

re:Invent 2019でのセッション資料 https://d1.awsstatic.com/events/reinvent/2019/REPEAT_1_Best_practices_for_AWS_Lambda_and_Java_SVS403-R1.pdf https://youtu.be/ddg1u5HLwg8

他に見つけたブログ https://pattern-match.com/blog/2020/03/14/springboot2-and-aws-lambda-provisioned-concurrency/

· 約6分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

(2022/7/3更新)過去に作成していた障害の履歴を確認するサイトが見れなくなっていたので、改めて作成しました。AWSとGCPの障害情報が確認できます。

Cloud Status History

サイトの実現方法の解説は個人ブログをご参照ください。


(2020/6/13更新)後半に記載しているJSONですが、どうも更新にタイムラグがあるようで、状況が[RESOLVED]になってから登録されるようです。


4/20の夜にAWSの東京リージョンでSQSやLambdaに障害があったようです。 AWSも無敵ではありません。

障害があった際にすぐに気づきたいですね。

Service Health Dashboardをチェック​

AWSに障害が発生した場合には、こちらのサイトでアナウンスされます。 https://status.aws.amazon.com/

こちらのサイトにはRSSも配信されているので、RSSリーダーでチェックしておくと良いですね。 しかし、、、

サービスごとにチェックするRSSファイルが分かれている!!! 「Tokyo」で検索しても120件。。。全件手動で登録するのは無理ですね。 (Slackに通知を行うとか今どきのものを考えたのですが、手動で120件も登録できません。。。)

全RSSファイルをまとめたRSSファイルを作る​

Lambdaで定期的にスクレイピングする作戦です。やってやれんことはない。 できたファイルはS3にでも格納して外から見れるようにしましょう。 この例ではService Health Dashboardのタブを一つ指定して処理をするようにしました。 Asia Pacificタブは数が多く、1回に5分ほど時間がかかります。

import os
import requests
from bs4 import BeautifulSoup

base_url = 'https://status.aws.amazon.com'

rss_template = ('<?xml version="1.0" encoding="UTF-8"?>'
'<rss version="2.0">'
' <channel>'
' <title><![CDATA[AWS Service Status]]></title>'
' <link>http://status.aws.amazon.com/</link>'
' <description><![CDATA[AWS Service Status]]></description>'
' </channel>'
'</rss>'
)

def get_rss_list(block):
print('start get_rss_list')
res = requests.get(base_url)
aws_soup = BeautifulSoup(res.text, 'lxml')

tables = aws_soup.find(id=block).find_all('table')

links = []

for tr in tables[1].find('tbody').find_all('tr'):
tds = tr.find_all('td')
links.append({'service': tds[1].text, 'url': tds[3].find('a').get('href')})

return links

def get_rss_item(rss_url):
print(rss_url)
response = requests.get(rss_url)
return response.text

def add_rss_item(rss_text, rss_path, service_name, output_soup):
rss = BeautifulSoup(rss_text, 'xml')
items = rss.find_all('item')
for item in items:
category = rss.new_tag('category')
category.append(service_name)
item.append(category)
output_soup.find('channel').append(item)

def put_object(rss_string, block):
import boto3
client = boto3.client('s3')
client.put_object(
ACL='public-read',
Body=rss_string.encode('utf-8'),
Bucket=os.getenv('S3_BUCKET'),
Key='aws-status'+block+'.rss',
ContentType='application/rss+xml'
)

def lambda_handler(event, context):
block = event['block']
print(block)

output_soup = BeautifulSoup(rss_template, 'xml')

for rss in get_rss_list(block):
url = base_url + rss['url']
text = get_rss_item(url)
add_rss_item(text, url, rss['service'], output_soup)

put_object(str(output_soup), block)

全リージョンの障害情報が取得できるJSONの存在​

ここまで頑張って作ったあとに、全リージョンの障害情報が取得できるJSONファイルがあることを知りました。さすがClassmethodさん。憧れる。

【小ネタ】AWSで過去に発生した障害の履歴を確認する方法 | Developers.IO https://dev.classmethod.jp/articles/service-health-status-history/

https://status.aws.amazon.com/data.json がそのJSONです。RSSとだいたい同じ情報が取得できます。 これをRSSにしてやれば、良さそうですね。 処理時間も30秒以内に終わるので、API GatewayでRSSを配信できます。

import requests
from bs4 import BeautifulSoup
from bs4.element import CData
from datetime import datetime, date, time, timezone, timedelta

rss_template = ('<?xml version="1.0" encoding="UTF-8"?>'
'<rss version="2.0">'
' <channel>'
' <title><![CDATA[AWS Service Status]]></title>'
' <link>http://status.aws.amazon.com/</link>'
' <description><![CDATA[AWS Service Status]]></description>'
' </channel>'
'</rss>'
)

item_template = ('<item>'
' <title></title>'
' <link>http://status.aws.amazon.com/</link>'
' <pubDate></pubDate>'
' <guid isPermaLink="false"></guid>'
' <description></description>'
' <category></category>'
'</item>')

def lambda_handler(event, context):
soup = BeautifulSoup(rss_template, 'xml')

r = requests.get('https://status.aws.amazon.com/data.json')
json = r.json()

JST = timezone(timedelta(hours=+9), 'JST')

for item in json['archive']:
title = item['summary']
pubDate = item['date']
pubDate = datetime.fromtimestamp(int(item['date']),JST).strftime('%a, %d %b %Y %H:%M:%S %Z')
guid = item['service'] + item['date']
description = item['description']
category = item['service_name']

item = BeautifulSoup(item_template, 'xml')
item.title.append(title)
item.pubDate.append(pubDate)
item.guid.append(guid)
item.description.append(CData(description))
item.category.append(category)

soup.find('channel').append(item)

response = {
'statusCode': 200,
'isBase64Encoded': False,
'headers': {'Content-Type': 'text/xml;charset=UTF-8'},
'body': str(soup)
}

return response

Webサイトにもしてみました。​

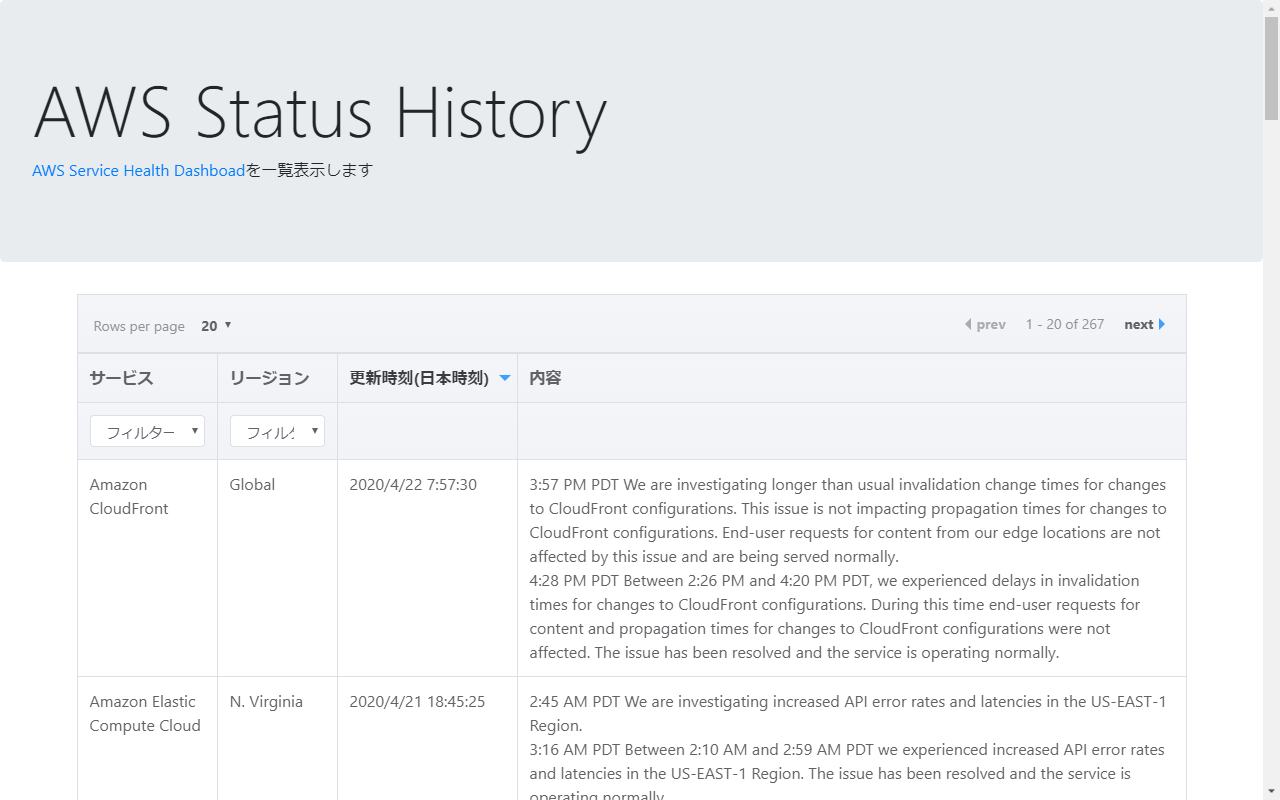
data.jsonを使って履歴を確認するWebサイトにしてみました。 4/20の東京リージョンの障害のあとにもバージニアのEC2、4/22のCloudFrontにも障害があったようです。

https://aws-status-rss.s3-ap-northeast-1.amazonaws.com/index.html

image.png

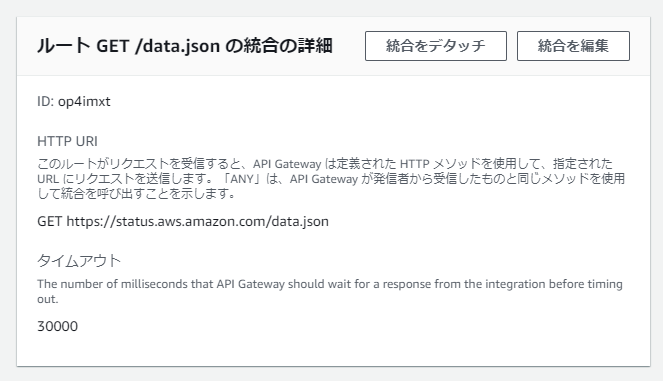
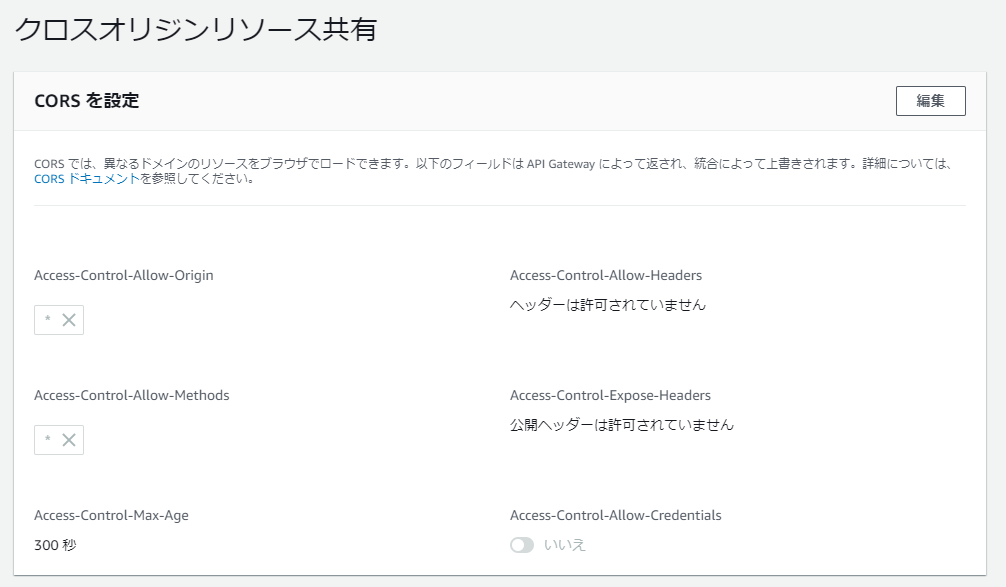
JSONを取得して整形しているだけですが、data.jsonの取得はCORSに引っかかるため、API GatewayのHTTP APIにてCORSを有効にしたHTTP プロキシ統合を作って回避しました。

image.png

image.png

· 約4分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

2017年に書いたポートの開放することなく、Respberry Piに外からアクセスするの第2弾です。

自宅に設置したRaspberry Piに外出先からアクセスしたいことってありますよね。 でも、そのためだけにルーターのポートを解放するのも、セキュリティが心配。

今回はAWS Systems Manager Session Managerを使う方法をご紹介します。 SSHもVNCもポートの開放も不要ですよ!

AWS Systems Manager Session Managerとは​

公式サイトによると

Session Manager はフルマネージド型 AWS Systems Manager 機能であり、インタラクティブなワンクリックブラウザベースのシェルや AWS CLI を介して Amazon EC2 インスタンス、オンプレミスインスタンス、および仮想マシン (VM) を管理できます。

https://docs.aws.amazon.com/ja_jp/systems-manager/latest/userguide/session-manager.html

基本的にはEC2へのログインに使うと便利なものですが、実はSystems Managerはオンプレ環境でも使用でき、Session Manager機能もEC2でなくても利用できるのです。

導入手順​

以下、手順を追って説明します。

IAMサービスロールを作成する​

IAMロールを作成します。

項目内容
名称SSMServiceRole(任意の名前)
ポリシーAmazonSSMManagedInstanceCore(AWS 管理ポリシー)
信頼関係ssm.amazonaws.com

https://docs.aws.amazon.com/ja_jp/systems-manager/latest/userguide/sysman-service-role.html

アクティベーションを作成する​

Raspberry PiにSSMエージェントをインストールする際に必要なアクティベーションキーを作成します。

マネジメントコンソールのハイブリッドアクティベーションメニューから作成します。

項目内容
インスタンス制限1(任意の数)
IAM ロールSSMServiceRole(上の手順で作ったもの)
デフォルトのインスタンス名Raspberry Pi(任意の名前)

作成したあと、画面上にアクティベーションコードとアクティベーションIDが表示されるのでメモしておきます。

https://docs.aws.amazon.com/ja_jp/systems-manager/latest/userguide/sysman-managed-instance-activation.html

SSMエージェントをインストールする​

ここはRaspberry Pi上での作業となります。

mkdir /tmp/ssm
sudo curl https://s3.amazonaws.com/ec2-downloads-windows/SSMAgent/latest/debian_arm/amazon-ssm-agent.deb -o /tmp/ssm/amazon-ssm-agent.deb
sudo dpkg -i /tmp/ssm/amazon-ssm-agent.deb
sudo service amazon-ssm-agent stop
sudo amazon-ssm-agent -register -code "[activation-code]" -id "[activation-id]" -region "ap-northeast-1"
sudo service amazon-ssm-agent restart

[activation-code]と[activation-id]は前の手順でメモしたものを使用します。

https://docs.aws.amazon.com/ja_jp/systems-manager/latest/userguide/sysman-install-managed-linux.html

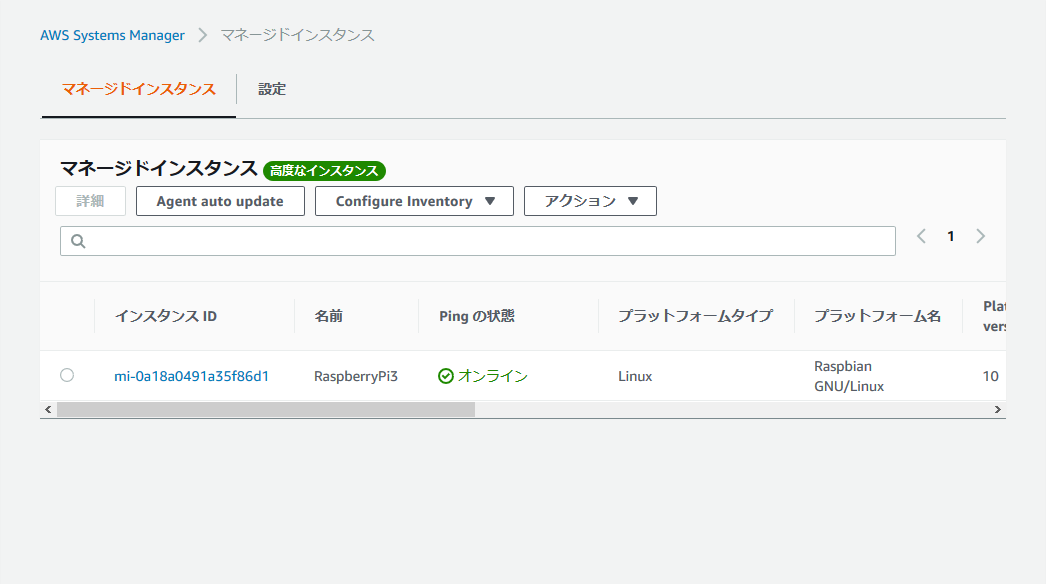
これで設定は完了です。 設置が完了すると、Session ManagerのマネージドインスタンスのところにRaspberry Piが追加されます。

image.png

接続手順​

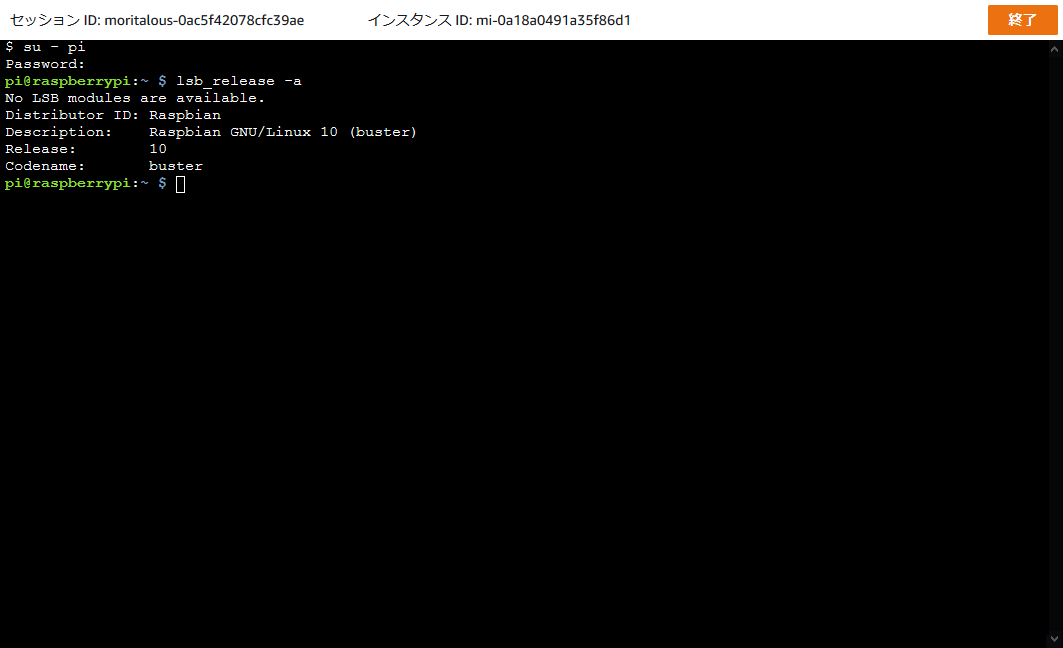
Session Managerのマネージドインスタンスのところでインスタンスを選択し、アクション -> Start Sessionを選択すると、ブラウザ上でターミナルの画面が表示されます。

これ、ブラウザの画面です。すごいですね。su - piとすることでpiユーザーへの切り替えもできます。

image.png

これでいつでもどこでもRaspberry Piと一緒です。 SSHもVNCも不要です。すごいですね。

· 約4分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

Greengrass Coreがv1.9.3でArmv6lをサポートしました。ラズパイZeroでもGreengrassが動作するようになりました。

https://docs.aws.amazon.com/ja_jp/greengrass/latest/developerguide/what-is-gg.html

久しぶりにGreengrassに触るので、Greengrassコネクタを使ってLチカをしてみました。 GreengrassコネクタにRaspberry Pi GPIOコネクタが用意されているので簡単です。

ラズパイZeroの準備​

以下の公式ドキュメントに従って行います。

Raspberry Pi のセットアップ https://docs.aws.amazon.com/ja_jp/greengrass/latest/developerguide/setup-filter.rpi.html

モジュール 2: AWS IoT Greengrass Core ソフトウェアのインストール https://docs.aws.amazon.com/ja_jp/greengrass/latest/developerguide/module2.html

Greengrassの設定​

リソースの追加​

Raspberry Pi GPIOコネクタがGPIOにアクセスするため、リソースを設定します。

対象のGreengrassグループを選択し、リソースタブを表示し、ローカルリソースの追加ボタンを押します。

設定項目設定値
リソース名任意の名前
リソースタイプデバイス
デバイスパス/dev/gpiomem
グループ所有者のファイルアクセス許可リソースを所有するLinuxグループのOSグループアクセス許可を自動的に追加
Lambda関数の関連無指定でOK

コネクタの追加​

Raspberry Pi GPIOコネクタを追加します。

対象のGreengrassグループを選択し、コネクタタブを表示し、コネクタの追加ボタンを押します。

Raspberry Pi GPIOを選択したあと、パラメータはこんな感じで指定しました。

設定項目設定値
Resource for /dev/gpiomem device作成したリソース
Input GPIO pins2 ※ボタンのGPIOピン番号
Input GPIO polling period50(millisecond)
Output GPIO pins17 ※LEDのGPIOピン番号

Lambdaの作成​

ボタンが押された/離されたイベントで起動し、LEDのオン/オフを設定する処理を行います。試行錯誤したのであまりきれいではありませんが。。

import os
import greengrasssdk
import json
import sys
import logging

## Setup logging to stdout
logger = logging.getLogger(__name__)
logging.basicConfig(stream=sys.stdout, level=logging.DEBUG)

iot_client = greengrasssdk.client('iot-data')

thingName = os.environ['AWS_IOT_THING_NAME']

def get_read_topic(gpio_num):
return '/'.join(['gpio', thingName, str(gpio_num), 'read'])

def get_write_topic(gpio_num):
return '/'.join(['gpio', thingName, str(gpio_num), 'write'])

def send_message_to_connector(topic, message=''):
iot_client.publish(topic=topic, payload=str(message))

def set_gpio_state(gpio, state):
send_message_to_connector(get_write_topic(gpio), str(state))

def read_gpio_state(gpio):
send_message_to_connector(get_read_topic(gpio))

def function_handler(event, context):
logger.info("Received message!")
logger.info(event)
logger.info(type(event))

# event
# 1 : button off
# 0 : button on

state = 0
if(event == 0):
state = 1
set_gpio_state(17, state)

return

LambdaにはAWS IoT Greengrass Core SDK for Pythonを含める必要があります。このあたりを参考にしました。

Lambda 関数の作成とパッケージ化 https://docs.aws.amazon.com/ja_jp/greengrass/latest/developerguide/create-lambda.html

Lambdaの追加​

作成したLambdaをGreengrassに追加します。

対象のGreengrassグループを選択し、Lambdaタブを表示し、Lambdaの追加ボタンを押します。

設定項目設定値
Lambdaの追加既存の Lambda 関数の使用
Lambda の選択作成したLambda
Lambda バージョンの選択作成したLambdaのバージョン

サブスクリプションの追加​

対象のGreengrassグループを選択し、サブスクリプションタブを表示し、サブスクリプションの追加ボタンを押します。

ボタンイベント -> Greengrassコネクタ -> Lambda呼び出し

ソースターゲットトピック
Raspberry Pi GPIOLambdagpio/+/ボタンのGPIOピン番号/state

Lambda -> Greengrassコネクタ -> LEDオンオフ

ソースターゲットトピック
LambdaRaspberry Pi GPIOgpio/+/LEDのGPIOピン番号/write

サブスクリプションをいじれば、クラウド経由でLチカも簡単です。

デプロイ​

これで設定は完了です。デプロイしましょう。