メインコンテンツまでスキップ

· 約6分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

前回 は失敗してしまいましたが、試行錯誤の上、上手く識別できるようになりました。 試行錯誤の軌跡を残します。

今回もこれ! 68747470733a2f2f71696974612d696d6167652d73746f72652e73332e616d617a6f6e6177732e636f6d2f302f34313537342f37326136333766332d653430372d356363342d643166302d3633393963396131316138632e706e67.png
画像の水増し​

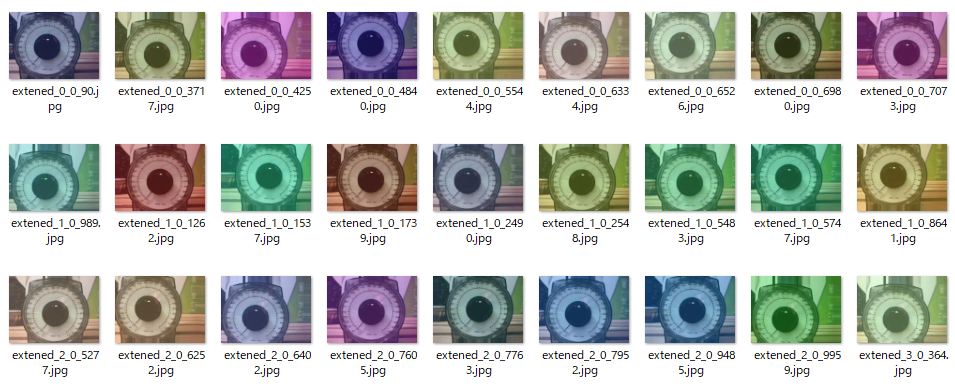
前回使用した画像は全部で400枚(正常200枚、異常200枚)でした。画像が少なすぎるのかと思い、画像を増やすことにしました。Kerasに便利な機能がありました。

自前のDeep Learning用のデータセットを拡張して水増しする https://qiita.com/halspring/items/7692504afcba97ece249

画像の前処理 - Keras Documentation https://keras.io/ja/preprocessing/image/

参考にしたサイトほぼそのままですが、今回のキッチンばかりの場合、画像の角度が重要だと考え、画像の回転はしないようにしました。

パラメーター設定値
rotation_rangeコメントアウト
horizontal_flipFalse
vertical_flipFalse
    # 拡張する際の設定
generator = ImageDataGenerator(
# rotation_range=90, # 90°まで回転
width_shift_range=0.1, # 水平方向にランダムでシフト
height_shift_range=0.1, # 垂直方向にランダムでシフト
channel_shift_range=50.0, # 色調をランダム変更
shear_range=0.39, # 斜め方向(pi/8まで)に引っ張る
horizontal_flip=False, # 垂直方向にランダムで反転
vertical_flip=False # 水平方向にランダムで反転
)

この方法で画像を10倍の4000枚(正常2000枚、異常2000枚)にすることができました。
スクリーンショット (298).png

モデルのパラメーターの変更​

Kerasのドキュメントを眺めて、今回の問題は「イヌ」「ネコ」「ゾウ」のように複数に分けるのではなく、「正常値」「異常値」の2つに分類するだけの問題だと気づきました。

Sequentialモデルのガイド - Keras Documentation https://keras.io/ja/getting-started/sequential-model-guide/

## マルチクラス分類問題の場合
model.compile(optimizer='rmsprop',
loss='categorical_crossentropy',
metrics=['accuracy'])
## 2値分類問題の場合
model.compile(optimizer='rmsprop',
loss='binary_crossentropy',
metrics=['accuracy'])
## 前回のコード(参考元のコピペです)
model.compile(loss='categorical_crossentropy',
optimizer='SGD',
metrics=['accuracy'])

真ん中の「2値分類問題」のコードに変更しました。 optimizerの意味は勉強します。

Optimizer : 深層学習における勾配法について https://qiita.com/tokkuman/items/1944c00415d129ca0ee9

画像のグレースケール化​

水増しした画像を見たときに、今回の問題は色情報は関係ないと思いました。 これもKerasで簡単にできました。(すごいね、Keras!!)

img = img_to_array(load_img(picture, target_size=(224,224), grayscale=True))

グレースケールにすることで、色情報がRGBの3から1になるので、input_shapeを追加で指定する必要があります。(指定なしだと3扱いなのかな?)

model = MobileNet(include_top=True, weights=None, classes=2,input_shape=(224, 224, 1))

モデルの変更(今回は不採用)​

モデルを変えると結果も変わるのかなと思って試したのですが、Raspberry Pi Zeroで予測させようとすると、メモリ不足で動作させることができませんでした。感覚がわかりませんが、Raspberry Pi Zeroの512MBのメモリで動作するって、すごいことなのでしょうね。

予測​

画像結果
1.jpg[[9.9999988e-01 1.2415921e-07]]
200g以下!

正解!
2.jpg[[1.0000000e+00 5.4107854e-08]]
200g以下!

正解!
3.jpg[[8.696176e-06 9.999913e-01]]
200g以上

正解!
4.jpg[[7.8308704e-10 1.0000000e+00]]
200g以上!

正解!
5.jpg[[4.8343203e-08 1.0000000e+00]]
200g以上!

正解!
6.jpg[[1.0000000e+00 1.5057713e-08]]
200g以下!

不正解!
(キッチンばかりの裏側)
想定外の画像のときってどうすればいいんだろう

予測のソース

## coding:utf-8

from time import sleep

from keras.applications import mobilenet

from keras.models import load_model
from keras.preprocessing import image
from keras.preprocessing.image import img_to_array, load_img
import numpy as np
from keras.utils import np_utils

model = load_model('0212_my_model_0216.h5', custom_objects={
'relu6': mobilenet.relu6,
'DepthwiseConv2D': mobilenet.DepthwiseConv2D})

while True:
X = []

picture = '/home/pi/motion/capture/lastsnap.jpg'
img = img_to_array(load_img(picture, target_size=(224, 224), grayscale=True))
X.append(img)

X = np.asarray(X)
X = X.astype('float32')
X = X / 255.0

features = model.predict(X)

print(features)
if features[0][0] > features[0][1]:
print('200g以下!')
else:
print('200g以上!')

sleep(5)

終わりに​

なんとか上手く分類させることができました。 ただ、閾値を200gから300gに変えたくなったらもう一回学習させないといけないのかな? 「マルチクラス分類」にすればいいのかな?

おまけ​

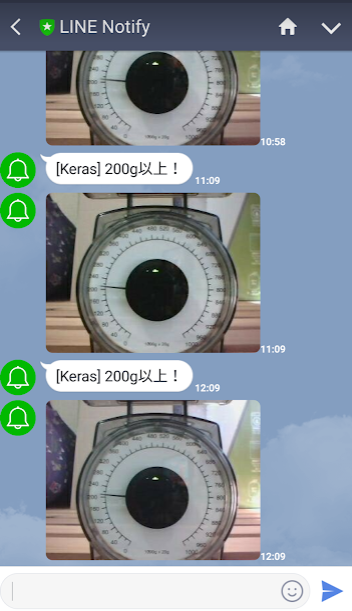
予測に使った画像と予測結果をLINE Notifyで通知したら、なんか、やったった感。
スクリーンショット (300).png

PythonからLINE NotifyでLINEにメッセージを送る https://qiita.com/tadaken3/items/0998c18df11d4a1c7427
· 約8分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

ディープラーニングの本をいくつか読んだけど、いまいちピンとこない。 技術的にすごいことはわかったけど、で?って感じでした。 画像認識したかったらAmazon Rekognitionとか使えばいいんでしょ?自分でディープラーニングすることなくない?と思ってました。

手を動かすことにしました。 →上手くいかなかった。。原因をだれか、教えて!!

題材​

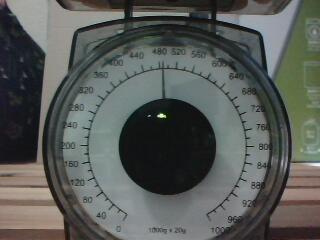
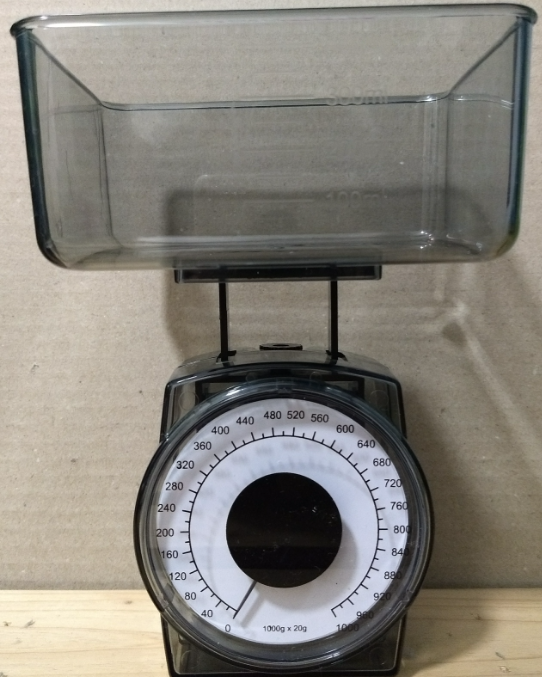
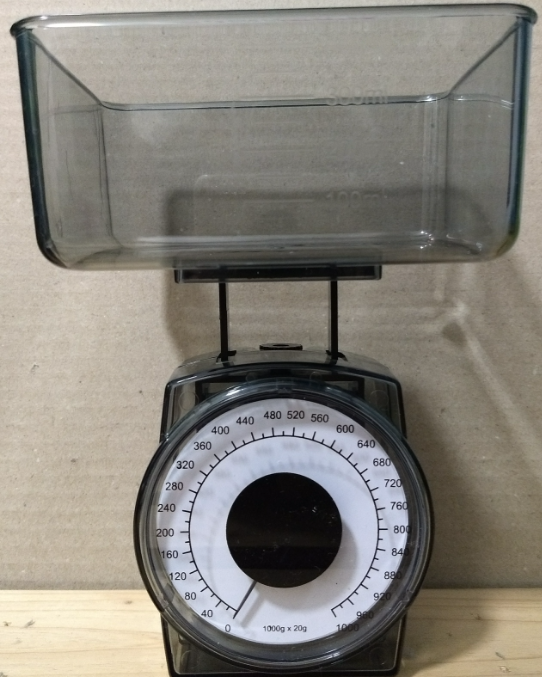
ダイソーで秤を買いました。 メモリが200g以下になったことを検知して「もうすぐ無くなるよ!」と言えれば、何かと役に立つのではないかと考えました。

スクリーンショット (294).png

画像の取得​

画像はRaspberry Pi Zero にUSBカメラ(Logicool C200)をつけて撮りました。

環境セットアップ​

Raspberry Pi でカメラ https://qiita.com/suppy193/items/e9faedbc268d439bd02b を参考に、インストールとmotion.confを変更。起動はこちらの方法で行いました。

sudo motion -n

起動後、http://xxx.xxx.xxx.xxx:8080にアクセスし、以下の設定を変えました。

設定項目変更後の値
target_dir/home/pi/motion
text_right(not defined)
text_event(not defined)
snapshot_interval1

設定変更は即時反映のようです。 こうして1秒間隔で画像を取得しました。

取得した画像​

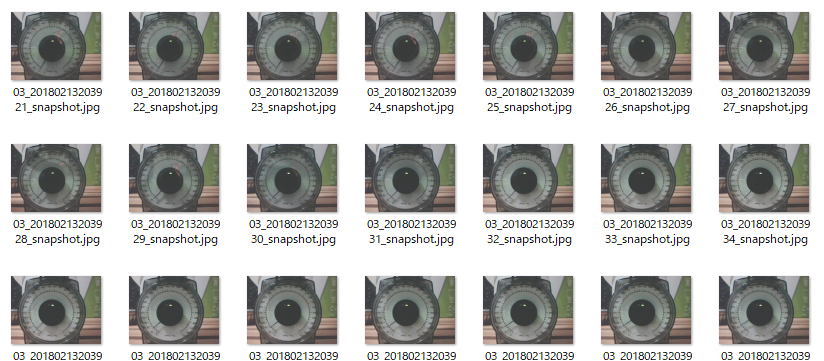
秤のうえに牛乳パックをおいて、水をチョロチョロいてれるところを1秒間隔でキャプチャ。 こんな感じです。

スクリーンショット (296).png

200g以下の画像を200枚、200g以上の画像を200枚ほど用意しました。

学習​

Kerasを使いました。主にこちらを参考にしました。

kerasでCNN 自分で拾った画像でやってみる https://qiita.com/haru1977/items/17833e508fe07c004119

モデルもそのまま参考にしても良かったのですが、何がなんやらわからなかったので、Kerasが予め対応している有名なモデルをそのまま使うことにしました。Googleの人が作ったものだとすごいんでしょ的な発想でMobileNetを選びました。

利用可能なモデル https://keras.io/ja/applications/

また、作ったモデルを保存しました。

Keras modelを保存するには? https://keras.io/ja/getting-started/faq/#keras-model

できたコードがこちら

0212_train.py
## coding:utf-8

from keras.applications.mobilenet import MobileNet

from keras.preprocessing import image
from keras.preprocessing.image import array_to_img, img_to_array, list_pictures, load_img
import numpy as np
from keras.utils import np_utils
from sklearn.model_selection import train_test_split

X = []
Y = []

## 対象Aの画像
for picture in list_pictures('./test0212_1_50/'):
img = img_to_array(load_img(picture, target_size=(224,224)))
X.append(img)

Y.append(0)

## 対象Bの画像
for picture in list_pictures('./test0212_2_100/'):
img = img_to_array(load_img(picture, target_size=(224,224)))
X.append(img)

Y.append(1)

## arrayに変換
X = np.asarray(X)
Y = np.asarray(Y)

## 画素値を0から1の範囲に変換
X = X.astype('float32')
X = X / 255.0

## クラスの形式を変換
Y = np_utils.to_categorical(Y, 2)

## 学習用データとテストデータ
X_train, X_test, y_train, y_test = train_test_split(X, Y, test_size=0.33, random_state=111)

## MobileNetのモデルを利用
model = MobileNet(include_top=True, weights=None, classes=2)

## コンパイル
model.compile(loss='categorical_crossentropy',
optimizer='SGD',
metrics=['accuracy'])

## 学習
history = model.fit(X_train, y_train, epochs=15,
validation_data = (X_test, y_test), verbose = 1)

filepath = '0212_my_model.h5'
model.save(filepath)

学習開始!​

python -m 0212_train

処理が終わるとモデルが出来上がります。

躓いた点1「ファイル名問題」​

画像のファイル名に-があるとだめでした。-はファイル名に使えないってそういうもんなんでしょうか?-を_に一括置換して対処しました。

ファイル名を一括置換するワンライナー https://qiita.com/goking/items/ff6ea22a4b5559d30896

ls -1 *.jpg | awk '{print;gsub(/-/,"_");print}' | xargs -n 2 mv

躓いた点2「パソコンスペック低すぎ問題」​

書くのも恥ずかしいスペックのパソコンしか持ってないので、学習にすごーーーーく時間がかかりました。 正確には、時間がかかりそうだったので途中でやめました。 ちょうど見つけた以下の内容を参考にColaboratoryを使いました。するとあっという間に終わりました。すごい、GPU!!

【秒速で無料GPUを使う】深層学習実践Tips on Colaboratory https://qiita.com/tomo_makes/items/b3c60b10f7b25a0a5935

予測​

Raspberyy Pi zeroにkerasとTensorFlowをインストールしようとしましたが、pip install kerasでは時間がめっちゃかかるのとエラーになっちゃいました。調べると、ビルド済みのものがあるようなので、そちらを利用することにしました。

RasPiでKeras/TensorFlowを動かす https://qiita.com/kazunori279/items/1e23679c534a49c0e837

http://ci.tensorflow.org/view/Nightly/ にあるnightly-pi-zero-python3の成果物tensorflow-1.6.0rc0-cp34-none-any.whlを使うことにしました。

その先のインストールが結構手間取ったので、正しい手順が示せません。。

ソースはこちら

0212_predict.py
## coding:utf-8

from time import sleep

from keras.applications import mobilenet

from keras.models import load_model
from keras.preprocessing import image
from keras.preprocessing.image import img_to_array, load_img
import numpy as np
from keras.utils import np_utils

model = load_model('0212_my_model.h5', custom_objects={
'relu6': mobilenet.relu6,
'DepthwiseConv2D': mobilenet.DepthwiseConv2D})

while True:
X = []

picture = '/home/pi/motion/lastsnap.jpg'
img = img_to_array(load_img(picture, target_size=(224, 224)))
X.append(img)

X = np.asarray(X)
X = X.astype('float32')
X = X / 255.0

features = model.predict(X)

print(features)

if features[0][0] > 0.5:
print('水が減っています! (' + str(features[0][0]) + ')')
else:
print('水は十分あります! (' + str(features[0][0]) + ')')

sleep(60)

予測結果​

失敗。。。 ものをおいても、置かなくても「水が減っています!」

(venv) pi@pizero:~/motion/python/project $ python -m 0212_predict
Using TensorFlow backend.
[[1.000000e+00 5.362379e-25]]
水が減っています! (1.0)
[[1.000000e+00 6.591085e-25]]
水が減っています! (1.0)
[[1.0000000e+00 6.2064603e-25]]
水が減っています! (1.0)
[[1.000000e+00 6.305497e-25]]
水が減っています! (1.0)
[[1.0000000e+00 1.2839705e-24]]
水が減っています! (1.0)

終わりに​

ダイソーの秤が200g以下かどうかは、残念ながらAmazon Rekognitionではわかりません。 クラウドが提供しているものはあくまで汎用的な画像認識。 クラウドのAPIでできない画像認識/分類をしたければ、自分でモデルを作らなくちゃいけない。逆にモデルさえ作っちゃえば、世界にひとつだけの、画像認識システムができるんですね。 失敗しちゃったけど。。。

· 約4分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

Firefox開発元のMozillaがIoTデバイスを管理するGatewayを公開しました。 バージョン0.3なので初公開ではないのかな? いち早く使ってみました。

公式サイト

インストール手順のブログ →インストール手順はここを参考にしました。

GitHubのWiki →インストールした後に何ができるかよくわからなかったのですが、ここに書いてあります。

用意したもの​

  • Raspberry Pi Zero W
  • SDカード 4GBでいけました

インストール​

  1. ここからOSイメージをダウンロード
  2. EtcherでSDカードにコピー
  3. SDカードをRaspberry Piにセット
  4. 電源オン
  5. 初回起動時にはRaspberry PiがWi-Fiのアクセスポイント(SSID:Mozilla IoT Gateway)として起動するので、パソコンをそっちのWi-Fiに接続する
  6. ホスト名はgateway.localなので、ブラウザでアクセス。
    ※私の環境(Windows 10)では上手く接続できなかったので、ipconfigしてデフォルトゲートウェイのIPアドレスに接続しました。
  7. Wi-FiルーターのSSIDが表示されるので選択、パスワードを入力。
  8. 「Connecting...」の表示になると、Raspberry Piのアクセスポイントオフになり、Wi-Fiルーター側のネットワークに接続します。
  9. パソコンをWi-Fiルーターに接続しなおし、再度gateway.localにアクセス。
  10. 外からアクセスするためのドメインxxxxx.mozilla-iot.orgが取得できるので、xxxxxの部分とメールアドレスを入力
  11. 確認メールが届くので、メール記載のURLにアクセス。
  12. ユーザーアカウントを作成する。

これで初期設定が完了です。 お気づきかとおもいますが、専用のドメインが取得できますので、これで外からもアクセスできます。

できること​

機器制御​

アドオンを追加することで様々な機器に対応できる仕組みになっています。バージョン0.3で用意されているアドオンは以下のものです。 残念ながら我が家には対応した機器がありません。

  • GPIO → 後述
  • Philips Hue
  • TP-Link
  • Virtual Things
  • Zigbee
  • Z-Wave

そのうちAlexaやGoogle Homeに対応するかなー。期待大。

フロアマップ​

フロアマップが作れるみたいです。へー。

ルール​

IFTTT的な「○○になったら××する」ができます。

GPIOでLチカしてみよう​

ここの内容です。 https://github.com/mozilla-iot/wiki/wiki/Configuring-GPIO-for-use-with-the-gpio-adapter

初期状態で18番ピンに割当らてています。 上の手順に沿って、ボタンの設定をしても何も変わらず。。

Raspberry Piとスマホは同じWi-Fiに接続していますが、Wi-Fiを切ってもインターネット経由でオンオフができました。

その他​

Raspberry Piにログインしたい​

初期状態ではユーザーpi、パスワードraspberryです。SSHしたい場合にbootパーティションにsshファイルが必要なのも同じです。

https://github.com/mozilla-iot/wiki/wiki/Logging-into-the-Raspberry-Pi

· 約6分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

スマートホーム楽しいですね。

  1. Echo Dot購入
  2. 「天気が聞ける目覚まし」だともったいない
  3. 家電を操作したい
  4. できた!感動!!
  5. さらにスマホのAlexaアプリで外からも操作できる!!!
  6. でもAlexaアプリが使いにくい⤵⤵⤵
  7. Googleアシスタントでもできるようにしよう!!!!

ここまで来ました。

Echoからの家電操作​

Echoからの家電操作は以下の投稿が参考になると思います。 Node-REDがキモです。初代Raspberry Piでも問題なく動作します。

Raspberry Pi での Node-RED 利用 https://qiita.com/minatomirai21/items/184e04bab76bee70470e

ラズベリー・パイ専用 学習リモコン基板 ADRSIRを動かす(AlexaやNode-REDも使って) https://qiita.com/michan06/items/08514e8e67960e45ff69

Amazon Echoで「○○をつけて」と言って家電を操作する https://qiita.com/machu/items/122c8403b35748bd5f4c

Amazon Echoとラズパイで、音声で照明をon/offする https://qiita.com/kikuzo/items/753b5065dde9633bda18

irMagician + Node-RED + Amazon Echo (互換機) - 設定編 https://qiita.com/ooo_6502/items/da30035e41b3dbe5391b

Googleアシスタントからの家電操作​

さて、Googleアシスタントを使った家電操作について調べたところ、大きく2つの方法が見つかりました。

  • Raspberry PiをWebサーバーにしてDDNSで公開
  • Beebotteというサービスを使う

Google HomeでRaspberry Piを経由してリモコンをコントロールする https://qiita.com/from_Unknown/items/5cf452cbf0ca74c4248a

IFTTT から Raspberry Pi に指示を出す https://qiita.com/minatomirai21/items/4c4e777b43ede1e42900

LINEをトリガーに家のGoogleHomeを喋らせる https://qiita.com/ktetsuo/items/5cd3cc72f18fa885affd

ポートの開放することなく、Respberry Piに外からアクセスすると投稿している以上、ポートを開放しない縛りでいきたいのと、単純に模倣するだけでは面白くないのでBeebotteを使わずTwitterを使うことにしました。

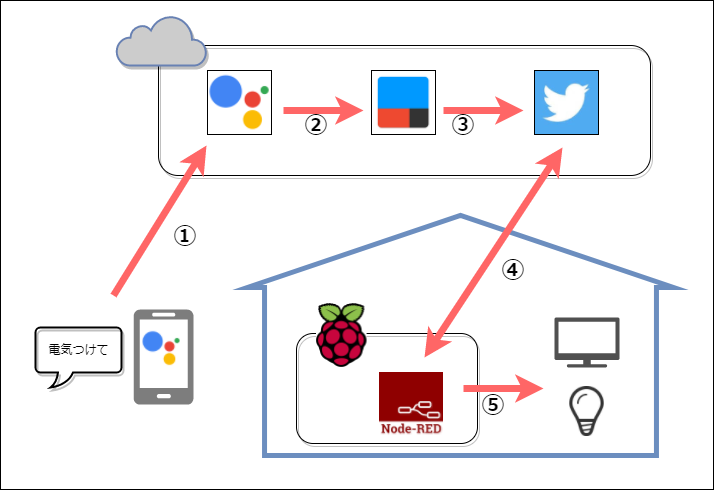
仕組み​

スマートホーム (2).png

No説明番号
1Googleアシスタントに「テレビつけて」と言う①
2Googleアシスタントで「テレビつけて」を受けたら、Twitterに「テレビつけて」とツイートする②③
3Node-REDでTwitterを監視。自分のアカウントが「テレビをつけて」とつぶやいたら家電操作④⑤

簡単!ノンプログラミング!サーバーレス!マイクロサービス!

IFTTTの設定​

トリガーにGoogleアシスタント、アクションにTwitterを設定したのですが、一つ問題が発生しました。 Twitterの制限で同じ内容のツイートは1回しか呟けないようです。 そこで末尾にタイムスタンプをつけて回避します。

トリガーがGoogleアシスタントのときには{{CreatedAt}}というパラメーターを付与できるのですが上手くいかなかったので以下のようにして回避しました。

Noトリガーアクション
1Googleアシスタントに「テレビつけて」Webリクエストで次のNo.2を呼ぶ
2WebhookでNo.1のリクエストを受けるTwitterに「テレビつけて{{OccurredAt}}」とツイート

Node-REDの設定​

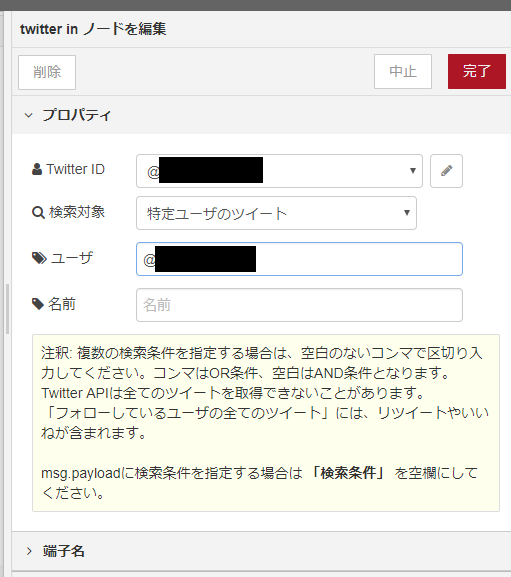
Twitter in ノードを使うことで、特定のユーザーのツイートを監視することができます。ツイートをトリガーにして、フローを作っていきます。

スクリーンショット (288).png

スクリーンショット (289).png

switchで「テレビつけて」が含まれるものだけにフィルターをかけ、execノードでテレビを付けるスクリプトを実行します。

スクリーンショット (290).png

スクリプトだけは自力で作りました。 スクリプト実行後は、「つけました」と呟くもいいですし、更にIFTTTのWebhookにリクエストするなど、もう、なんでもできます。

終わりに​

ポートの開放もないですし、各サービスのアカウントを乗っ取られない限り、 比較的セキュリティも確保できるのではないでしょうか?

注意点としてはTwitterのアカウントを専用に用意しツイートを非公開にすることをオススメします。そうしないと「テレビ消します」=外出中がバレてしまいますので。

ちょっとタイムラグはありますが、実用的です。

番外編​

私の朝食は食パンですが、よく買い忘れます。 上で紹介した仕組みを改良して、食パンがないときにスマホに通知が来るようにしました。 もうスマートホームではありません。スマート食パンです。

Noトリガー&アクションサービス
1家の近くのコンビニに近づいたら、Twitterに「食パンある?」と呟くIFTTT + Android Location
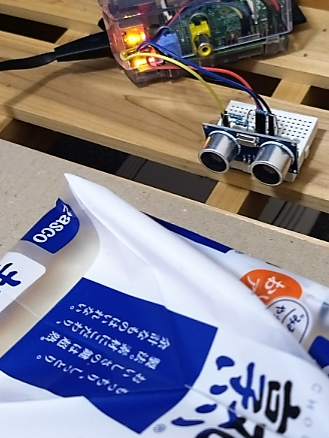
2Twitterの「食パンある?」つぶやきを監視し、HC-SR04(超音波距離センサー)で食パンとの距離を計測。30cm以上だったら「食パンなし」とするRaspberry Pi + HC-SR04
3食パンがないときは、Webhookを呼ぶIFTTT + Webhook
4Webhookを受けたらLINE Notifyで「食パンないよ」と通知IFTTT + LINE Notify
5食パン買い忘れない!!

スクリーンショット (292).png

次は冷蔵庫の中監視したいな。。

· 約4分
moritalous
お知らせ

過去にQiitaに投稿した内容のアーカイブです。

前回「GoogleアシスタントをAlexa Skillにして「アレクサ、オーケーグーグルで天気を調べて」を実現する」という投稿をしました。

少し改良し、Googleアシスタントの声で応答を返すように改良しました。

こんな感じです。

処理の流れ​

  1. Echoに話しかける
  2. Skill Kit(AWS Lambda)にリクエストが来る
  3. Googleアシスタントにリクエストを投げる
  4. Googleアシスタントからレスポンス(音声・テキスト)が返却される
  5. 音声を一度tmp領域にファイル出力する
  6. ffmpegでAlexaのフォーマットに変換する
  7. 変換した音声ファイルをS3にアップロードする(バケットはパブリック公開しておく)
  8. S3にアップロードした音声ファイルのURLをaudioタグに入れたSSMLレスポンスを返却する
  9. EchoがGoogleアシスタントの声で返事をする

長くなりそうなので、要点だけ解説します。 ソースコードはこちら

Googleアシスタントからのレスポンスをファイルに出力する​

Googleアシスタントのレスポンス中のresp.audio_out.audio_dataが複数に分割されて取得されるので、連結してファイルに出力します。

response_audio_data = b''
for resp in self.assistant.Assist(iter_assist_requests(),
self.deadline):
if resp.audio_out.audio_data:
response_audio_data += resp.audio_out.audio_data
def save_file(output_path, binary):
with open(output_path, "wb") as fout:
fout.write(binary)

音声ファイルをAlexaのフォーマットに変換する​

Googleアシスタントのレスポンスは、mp3で取得できますが、Alexaが求める要件は以下の用になっています。

音声ファイルをAlexaに適した形式に変換する

必要に応じて、変換ソフトウェアを使用してMP3ファイルを必要なコーデックバージョン(MPEGバージョン2)とビットレート(48 kbps)に変換してください。

丁寧にffmpegのパラメーターの記述もあります。

ffmpeg -i <input-file> -ac 2 -codec:a libmp3lame -b:a 48k -ar 16000 <output-file.mp3>

ffmpegはLambdaの環境には準備されていないので、デプロイパッケージに含める必要があります。 ffmpegは ここ の「Linux Static Builds」のリンク先からx86_64 buildのものを取得しました。 取得したファイルの中にある、ffmpegバイナリーのみを、デプロイパッケージのルートに格納されるように圧縮します。

Pythonのプログラム中でffmpegを呼び出す部分はこんな感じです。

def convert(input_path, output_path):
try:
command = './ffmpeg -i '+input_path+' -ac 2 -codec:a libmp3lame -b:a 48k -ar 16000 -af volume=2.0 ' + output_path
output = subprocess.check_output(
command, stderr=subprocess.STDOUT, shell=True, timeout=3,
universal_newlines=True)
except subprocess.CalledProcessError as exc:
print("Status : FAIL", exc.returncode, exc.output)
else:
print("Output: \n{}\n".format(output))

つづく